Relatório preliminar. O universo pode ter mudado desde a coleta dos dados.
Medindo Kimi K3 através de um espelho: o que o canal de raciocínio fez e não fez
Este documento não publica um ranking. Nenhum modelo, resultado ou custo de execução é oferecido como veredito sobre quem vence. O objetivo é mais estreito: registrar o que um modelo de raciocínio frontier retornou através de um endpoint-espelho de terceiros, e registrar o que esse endpoint não retornou. Os dados ficaram no store SQLite do benchmark em 2026-08-09. Eles não serão reproduzíveis, e o motivo é estrutural, não técnico.
O modelo foi servido apenas por um endpoint-espelho de terceiros — um proxy custom anônimo compatível com OpenAI, não a API oficial da Moonshot. Não houve segundo caminho. Isso remove a possibilidade de isolamento de provedor. Esta é uma medição de um modelo visto através de um espelho opaco, não uma medição do espelho. A chave usada na execução era temporária e esperava-se que expirasse no mesmo dia em que foi emitida. Esse vencimento é o motivo de a execução ter acontecido. Uma chave revogada não pode ser repetida. Os achados abaixo são um retrato de uma única tarde.
Custo é nulo, não zero. A chave foi concedida; nenhum preço foi pago. Uma chave concedida não é um preço, e escrever "0" teria feito o modelo parecer infinitamente barato. Apenas como referência, e claramente não como preço pago aqui, o OpenRouter lista moonshotai/kimi-k3 a $3,00 / $15,00 por 1M de tokens de entrada / saída — cerca de 33x o preço de lista do DeepSeek-V4-Flash-0731. Esse número é preço de lista externo. Não é um custo que incorremos e não entra como evidência sobre a economia deste endpoint.
Setup
A suíte de benchmark conduz cada modelo através de uma camada de roteamento e registra latência, erros, timeouts e defeitos de transporte — não apenas a qualidade da resposta. Cada modelo recebe os mesmos prompts, o mesmo orçamento e as mesmas configurações. Dois braços foram medidos, ambos no mesmo espelho:
- kimi-k3 — configurações idênticas a todos os outros modelos da suíte. Este é o braço comparável.
- kimi-k3-max — carrega um
extra_bodyreplicando o protocolo de avaliação publicado pela Moonshot: temperature 1.0, top-p 0.95, max_tokens 32768, reasoning effort high. Este braço é comparável aos números publicados da Moonshot, não ao outro braço.
Os totais de tokens nos runs do Kimi K3 chegaram a cerca de 4,4M de tokens (kimi-k3-max ~3,4M, kimi-k3 ~0,98M).
Resultados
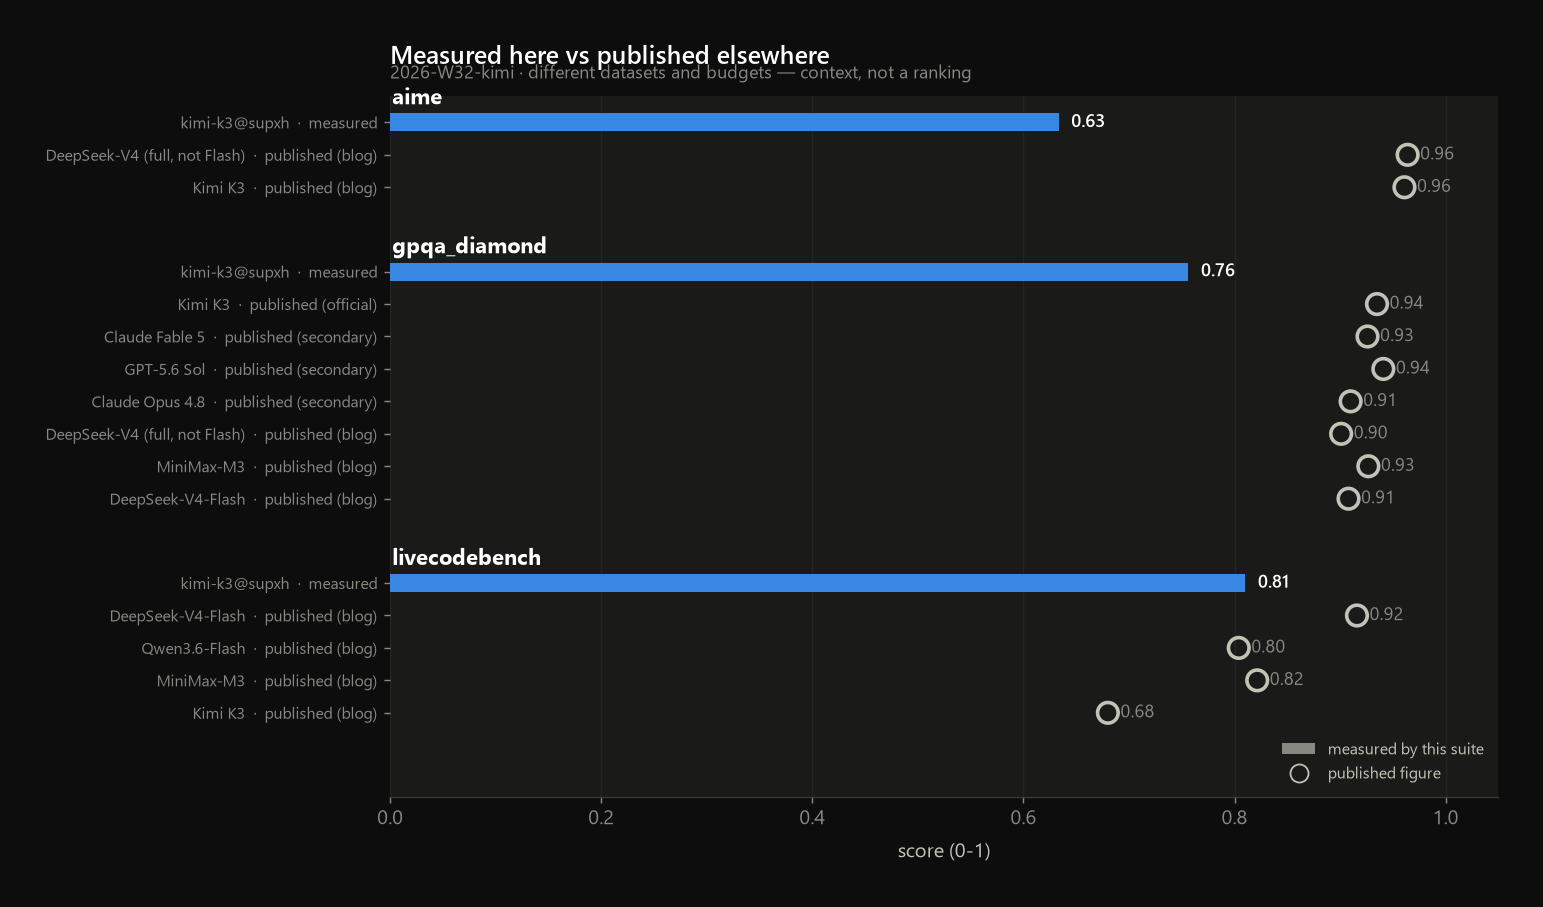
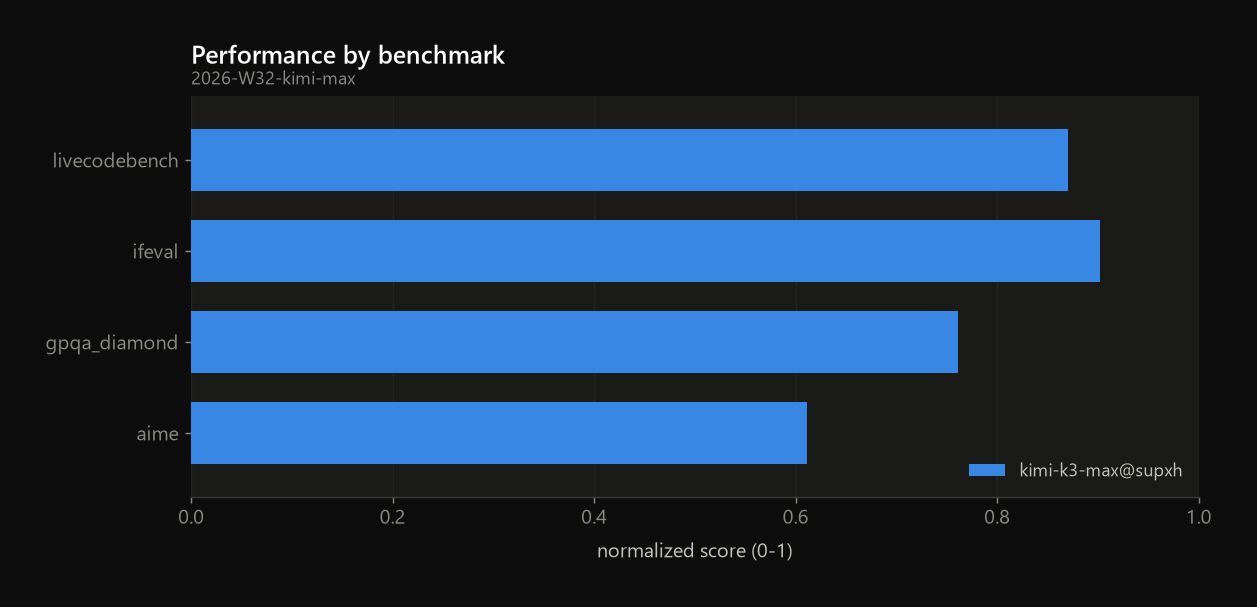
| Braço | Tentativas | GPQA Diamond | IFEval | LiveCodeBench | AIME | Latência média | Erros | |---|---|---|---|---|---|---|---| | kimi-k3 | 348 | 75,6% (n=160) | 87,6% (n=80) | 81,0% (n=18) | 63,3% (n=90) | ~20,8s | 1 | | kimi-k3-max | 1308 (run principal) | 76,1% (n=1120) | 90,2% (n=80) | 87,0% (n=18) | 61,1% (n=90) | ~17,4s | 0 |
GPQA Diamond no kimi-k3 é 40 perguntas x 4 permutações (n=160); no kimi-k3-max é 80 perguntas x 4 permutações x 3 repetições (n=1120). AIME no kimi-k3 é 30 problemas x 3 repetições, avg@k (n=90).
Contra o leaderboard publicado, o quadro é sóbrio e não é lisonjeiro. O número oficial da Moonshot para Kimi K3 no GPQA Diamond é 93,5% (reasoning max). Nossos valores medidos ficam em 76,1% e 75,6% — cerca de 17 pontos percentuais abaixo do número oficial, e abaixo de todo modelo frontier publicado no gráfico. Ambos os valores medidos ainda cruzam a linha do humano especialista (65%) por cerca de 11 pontos. Não atribuímos a lacuna. Ela pode ser distribuição de prompts, variância de amostragem, o espelho roteando para uma variante diferente, ou o canal de raciocínio ausente. Registramos a lacuna e deixamos a causa indeterminada.
O canal de raciocínio
O instrumento central aqui foi a saída separada de "pensamento". Medimos ela diretamente.
No braço comum kimi-k3, o raciocínio veio vazio em 348/348 tentativas. Zero texto de raciocínio em qualquer requisição, mesmo com effort configurado.
No braço kimi-k3-max, o raciocínio apareceu em apenas 380/1308 tentativas — cerca de uma em cada três. Especificamente no GPQA, o raciocínio apareceu em 380/1156 únicos. AIME, IFEval e LiveCodeBench produziram raciocínio em 0/90, 0/80 e 0/18, respectivamente. O canal ficou majoritariamente silencioso nos braços que mais deveriam falar.
Uma retratação, registrada honestamente
No início do dia, a hipótese de trabalho era "effort: max funciona". Uma amostra em um problema de AIME mostrou os tokens de conclusão subindo de 1.462 para 11.356. Esse delta único foi lido como sinal. Estava errado. O reteste no mesmo dia o retratou.
effort: "banana"— um nível que nenhuma API define — retornou HTTP 200 três vezes de três, caindo na mesma distribuição de pontuação que max e high.- Enviar nenhum bloco de raciocínio produziu uma resposta com 22.033 caracteres de raciocínio; enviar um tier definido produziu respostas sem nenhum. O canal aparecia e desaparecia sem correlação com o campo que deveria controlá-lo.
- No mesmo prompt, com cache rompido, os tokens de conclusão variaram de 3.025 a 21.165 — um spread de 7x. O antigo delta de 1.462 -> 11.356 fica dentro desse spread. A observação original estava medindo ruído.
Leitura atual mais provável: a decisão é feita a montante do modelo. Respostas que raciocinaram versus as que não raciocinaram vieram com formatos de id diferentes (UUID com hífens vs hex puro) e system_fingerprint diferentes (None vs ''). Isso é a assinatura de backends diferentes roteando, não de um modelo decidindo. Essa leitura é n=2. Sugestiva, não resolvida.
Taxonomia de falha
- Falha de modelo: nenhuma observada. As pontuações se mantiveram em ~75–76% de GPQA com ou sem raciocínio disparando. O modelo se sustenta sem um canal de raciocínio confiável.
- Falha de orquestração: o espelho roteia o raciocínio de forma não-determinística e ignora o campo de controle. A aceitação de
effort: "banana"é um defeito de orquestração, não um comportamento do modelo. - Falha de instrumentação: nenhuma. A suíte capturou o que o endpoint retornou. O silêncio era real, não uma lacuna de logging.
O que isso significa
A parte honesta é a retratação. Uma medição de amostra única parecia sinal; o reteste adequado mostrou que era ruído. Esta é a lição de medir através de um espelho: você não pode confiar no que um endpoint anuncia sobre raciocínio. Você só pode confiar no que consegue reproduzir, e neste espelho a saída de raciocínio não era reproduzível.
O Ministério Interplanetário de Infraestrutura recomenda manter os gráficos ligados — porque são honestos sobre onde um modelo medido realmente pousa — e os tratados internacionais frágeis.