Relatório preliminar. O universo pode ter mudado desde a coleta dos dados.
Kimi K3: default vs max — quanto custa o modo "max"?
Este documento não publica um ranking. Ele dá continuidade à medição do espelho: o mesmo endpoint-espelho de terceiros, os mesmos quatro benchmarks, a mesma suíte. A pergunta aqui é mais estreita e, provavelmente, a que um usuário faz de verdade: quando o modo "max" custa mais tokens e mais tempo de parede, o que ele compra? A resposta curta, neste run: nada mensurável — e os números agregados que sugerem o contrário são composição, não sinal.
Os runs são 2026-W32-kimi e 2026-W32-kimi-max, medidos em 2026-08-09, ambos contra o mesmo espelho (supxh). Dois braços:
- kimi-k3@supxh — o braço comum, configurações idênticas a todos os outros modelos da suíte. 348 tentativas.
- kimi-k3-max@supxh — carrega um
extra_bodyreplicando o protocolo de avaliação publicado pela Moonshot: temperature 1.0, top-p 0.95, max_tokens 32768, reasoning effort high. 1308 tentativas.
O espelho não honra reasoning.effort (estabelecido no post do espelho: um tier fajuto retorna 200 e o canal de raciocínio aparece e desaparece sem correlação com o campo). Então o braço "max" deve ser lido como uma segunda amostra, maior, do mesmo endpoint — que é exatamente por que os deltas abaixo caem dentro do ruído.
Resultados
| Braço | Marvin Score | Confiabilidade | Latência p50 | tok/s | Erros |
|---|---|---|---|---|---|
| kimi-k3@supxh | 0.767 | 99,7% | 7,7s | 159 | 0,3% |
| kimi-k3-max@supxh | 0.786 | 100% | 5,6s | 183 | 0,0% |
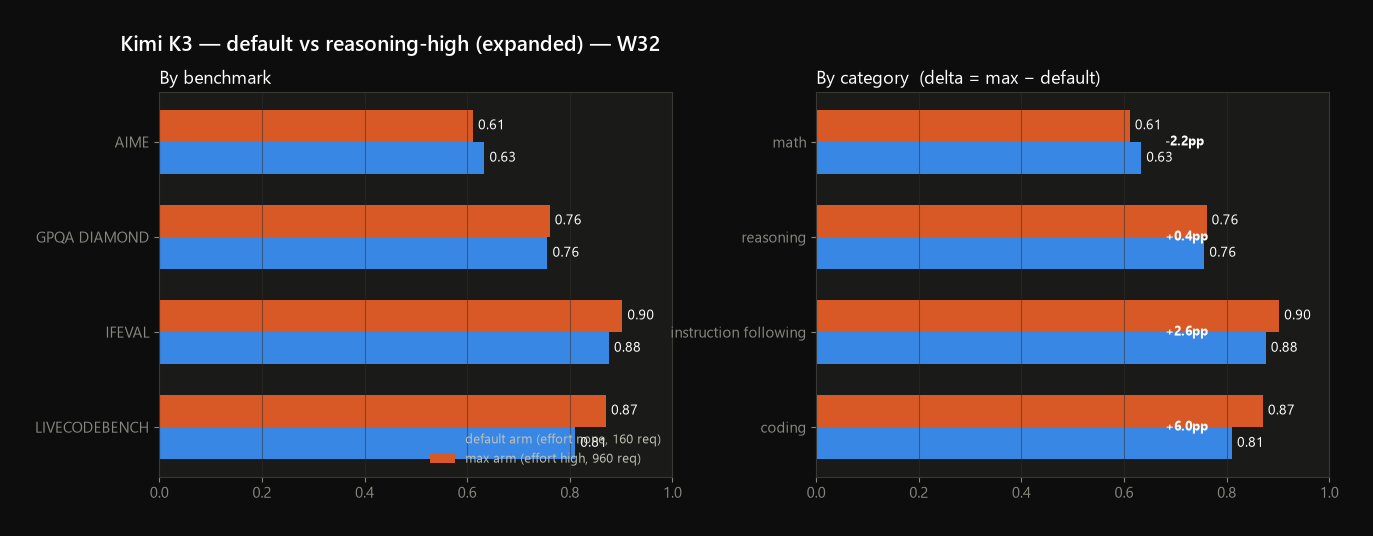
O agregado move +0.019 na direção do max e parece mais rápido. Nenhum dos dois sobrevive à checagem por benchmark.
O delta sobrevive ao ruído?
Os dois runs não compartilham os mesmos pools de itens — GPQA rodou 160 itens distintos no braço comum e 320 no braço max — então uma comparação agregada não é maçã com maçã. A comparação honesta é sobre os itens que ambos os braços responderam, com um bootstrap pareado (10.000 reamostragens) sobre esses itens compartilhados:
| Benchmark | Itens compartilhados | default | max | Δ | 95% CI | Leitura |
|---|---|---|---|---|---|---|
| aime | 30 | 0.633 | 0.611 | -0.022 | [-0.144, +0.100] | consistente com nenhuma diferença |
| ifeval | 80 | 0.876 | 0.902 | +0.026 | [-0.019, +0.074] | consistente com nenhuma diferença |
| livecodebench | 18 | 0.810 | 0.870 | +0.060 | [-0.130, +0.250] | consistente com nenhuma diferença |
| gpqa_diamond | 160 | 0.756 | 0.733 | -0.023 | [-0.080, +0.034] | consistente com nenhuma diferença |
Todo intervalo cruza zero. O maior delta pontual — coding, +0.060 — está em n=18, a célula mais ruidosa da suíte, e seu intervalo é mais largo que o próprio delta. Raciocínio é estável-para-levemente-pior nos itens compartilhados. Matemática é levemente pior. É o mesmo LiveCodeBench n=18 que já disse à comparação de provedores que não conseguia distinguir dois endpoints; não é agora que vai distinguir dois modos.
De onde vem o delta agregado
O +0.019 do título é um artefato de composição, e a categoria GPQA mostra isso com mais clareza. Nos 160 itens que ambos os braços responderam, o max marcou 0.733 contra 0.756 do default — mais baixo nos mesmos itens. O run max então adicionou 160 itens novos que por acaso marcaram 0.798, puxando o agregado para 0.761. A leitura publicada de "0.76 → 0.76, estável" para raciocínio é, na verdade, "levemente pior nos mesmos itens, mascarado por um sorteio de itens diferente". A mesma lógica infla a latência agregada: o run max é 86% chamadas de GPQA (o benchmark rápido, p50 ~5s) enquanto o run comum é só 46%, então o p50 de 5,6s contra 7,7s é efeito de mistura, não efeito de modo. Por benchmark a latência anda nos dois sentidos: aime 21,0→17,9s (mais rápido), ifeval 6,7→7,8s (mais lento), livecodebench 2,8→3,9s (mais lento), gpqa 5,6→4,9s (mais rápido, em itens diferentes).
O que o "max" de fato custa
| Benchmark | tok/chamada default | tok/chamada max | Δ de score (compartilhado) |
|---|---|---|---|
| aime | 5.700 | 6.970 | -0.022 |
| ifeval | 966 | 771 | +0.026 |
| livecodebench | 812 | 5.033 | +0.060 |
| gpqa_diamond | 1.452 | 1.753 | -0.023 |
Nos benchmarks onde o raciocínio deveria importar — AIME e LiveCodeBench — o braço max emite 1,2× e 6,2× mais tokens de saída por chamada, para deltas dentro do ruído. O canal de raciocínio disparou em 362/1.120 tentativas de GPQA no run max (0/348 no run comum, 0/90 em AIME, 0/18 em LiveCodeBench), o que o post do espelho já mostrou ser roteamento a montante, não um campo de controle funcionando. Você paga os tokens; o placar não se move.
O que isso significa
O modo custa tokens e não compra nada mensurável neste espelho. O +0.019 agregado não sobrevive ao ruído; o ganho de coding é uma célula de n=18 com intervalo mais largo que ela mesma; raciocínio é estável-para-levemente-pior em itens idênticos; matemática é levemente pior. Leia o n — e os pools de itens — antes de chamar um delta pequeno de real.
O Ministério Interplanetário de Infraestrutura recomenda gastar o orçamento de raciocínio em endpoints que comprovadamente o usam, e manter os tratados internacionais frágeis.