Relatório preliminar. O universo pode ter mudado desde a coleta dos dados.
O estado da bancada — síntese da safra 2026-W32
A safra W32 publicou dez posts de laboratório, mas nenhum deles contava a história inteira. Este é o post que junta os retalhos: o que três medições de Kimi K3, dois endpoints de DeepSeek-V4-Flash, uma sonda de transporte com quatro provedores e uma reforma do site têm em comum. A resposta curta: provedor determina produto, esforço não compra raciocínio, e o transporte é uma variável de engenharia — não um detalhe logístico. Os números vêm dos results.json de 2026-W32, 2026-W32-public, 2026-W32-kimi e 2026-W32-kimi-max (exportados de E:/marvinbench), com o n e o fingerprint da suíte acompanhando cada figura, como manda a metodologia.
Kimi K3: o raio-x do raciocínio
Três medições do mesmo espelho (supxh), na mesma suíte (478e23a78ea1): o espelho, o default vs max e o follow-up de GPQA. Juntas, elas formam um retrato consistente:
- GPQA Diamond estagnada em 0.76, independentemente do esforço: 0.756 (n=160) no default, 0.761 (n=1120) no
max. Sete vezes a amostra comprou meio ponto percentual — ruído, não sinal. - AIME varia sem subir: 0.63 no default → 0.61 no
max. O esforço extra não só não ajudou como o ponto caiu dentro do ruído. - IFEval e LiveCodeBench sobem com
max: 0.88 → 0.90 e 0.81 → 0.87. Seguir instrução e codar melhoram; raciocinar, não.
A leitura transversal é a tese do follow-up: GPQA é sensível ao que o roteador entrega, não ao esforço de inferência. O canal de raciocínio voltou vazio em 348/348 tentativas no default e em 72% das chamadas no max — o campo reasoning.effort controla o esforço na API, mas o espelho decidia sobre raciocínio a montante do modelo. Esforço não altera o resultado mensurável quando o canal que ele deveria comprar nem sempre existe. E o "0.76" repete o padrão do espelho: o número pousa ~17 pontos abaixo do valor oficial da Moonshot — porque medimos o serviço, não o folheto.
Provedor determina produto
O experimento de provedor pegou o mesmo peso (DeepSeek-V4-Flash), os mesmos prompts, o mesmo orçamento e a mesma pontuação — e trocou só o endpoint. No run público 2026-W32-public (mesma suíte 1d2792e98840, 3 benchmarks, 188 chamadas por braço):
- AIME colapsa: 0.244 via marvin vs 0.867 via openrouter. Delta pareado -0.622, intervalo de 95% [-0.767, -0.478] — não cruza zero, não é ruído. O mesmo modelo "perde" 62 pontos percentuais em math só porque o roteador o serviu de outro jeito.
- A confiabilidade inverte. marvin: 1.1% de erros, TTFT mediano de 1.4s. openrouter: 9.0% de erros, TTFT de 15.3s. O endpoint mais forte no placar bruto é o mais frágil na operação — o preço do AIME alto é 9x mais falhas e 10x mais latência.
O chart composto abaixo resume a safra inteira por braço — cada barra carrega o fingerprint da suíte e o número de benchmarks, porque scores de suítes diferentes não se comparam:
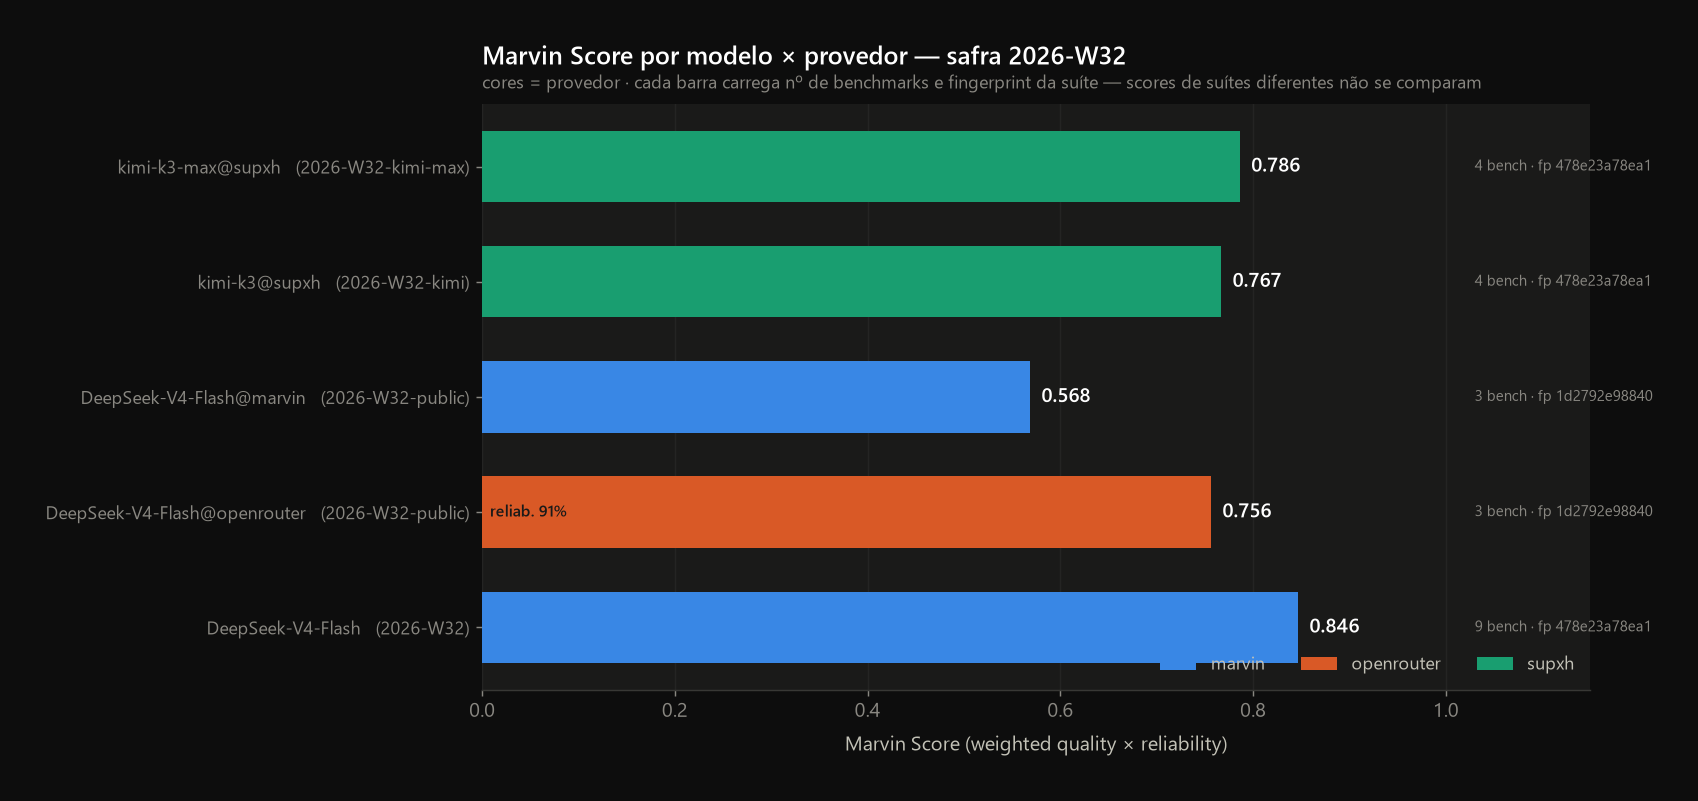
Repare no que o chart não mostra: o DeepSeek-V4-Flash@marvin marca 0.846 na bateria completa (9 benchmarks, run 2026-W32) e 0.568 no run público (3 benchmarks) — mesma marca, duas suítes, dois números. É exatamente por isso que o lineup se recusa a ser um ranking: comparar esses dois 0.5x seria comparar laranjas com o placar de outro jogo.
Transporte é variável de engenharia
A sonda de transporte levou o mesmo workload a quatro provedores e encontrou quatro produtos diferentes: latência total de 2.44s a dezenas de segundos, primeiro token de 1.03s num gateway que bufferiza tudo, throughput que varia por ordem de grandeza — e disponibilidade que separa status de conteúdo (HTTP 200 veio vazio em 4 runs). O n é pequeno (três runs por braço, numa tarde), então o que vale é a classe do achado, não o valor exato: para o mesmo peso, o transporte pode ser o gargalo dominante. Quem publica só o placar de qualidade está publicando metade do produto.
O retroativo do site: o laboratório e o site são o mesmo projeto
A mesma safra que mediu modelos reescreveu o chão do site: i18n end-to-end com registry tipado (commits 45ac8bb/d1fbdbb), a decisão de runtime do static export ao OpenNext com rate-limiter em KV (28e99fb) e o redesign Caderno de Campo (488a12c). Não é coincidência: os dez posts desta safra são renderizados por esse novo chão, e as figuras que eles citam vêm do mesmo harness que mede os modelos. O laboratório não alimenta o site — os dois são o mesmo projeto, com a medição e a publicação dividindo a mesma suíte de decisões.
O que isso significa
A safra W32 deixa três regras de leitura. Primeiro: esforço declarado não compra raciocínio — meça o que o roteador entrega, não o que o campo effort promete. Segundo: todo número de modelo é um número de modelo × provedor × transporte; citar um sem os outros é citar pela metade. Terceiro: a infraestrutura que publica também é produto — e na próxima safra, ela entra no placar.
O Ministério Interplanetário de Infraestrutura recomenda desconfiar de placares que não carregam o n, o fingerprint e o provedor — e manter os tratados internacionais frágeis.